AMD Radeon AI PRO R9700
যাইহোক, একটি বহিরাগত পরিষেবাতে গ্রাহকের তথ্য, চুক্তি এবং অভ্যন্তরীণ ইনভেন্টরি ডেটা পাঠানো সম্ভব নয়… এটি বিশেষত ছোট এবং মাঝারি আকারের ব্যবসার আইটি ম্যানেজারদের জন্য একটি সমস্যা যেগুলির একটি ডেডিকেটেড AI বিভাগ নেই৷ এমনকি যদি ডেটা কোম্পানির বাইরে প্রকাশিত হয়, তবে মডেলটি ব্যবহার করার জন্য কোনও মাসিক ফি নেই, যা হল “ইন-হাউস AI”।
তবে পরিবেশ তৈরি করতে হলে কাজ একই থাকে। যাইহোক, প্রশ্ন হল যে একটি ক্ষেত্র ব্যবহার কিভাবে. এইবার, গল্পটি ছোট এবং মাঝারি আকারের উদ্যোগের আইটি কর্মীদের সম্পর্কে যারা তিনটি বিভাগে সমস্যার সমাধান করছেন: “সেলস,” “ইনভেন্টরি ম্যানেজমেন্ট,” এবং “গবেষণা’ প্রকৌশলীদের কাছ থেকে পরামর্শ নেওয়ার সময়।
গোপনীয় তথ্য ক্লাউড এআই-তে ইনপুট নাও হতে পারে
কিছু কোম্পানি বহিরাগত AI পরিষেবাগুলিতে গ্রাহকের তথ্য বা চুক্তি পাঠাতে পারে না। এটিই প্রথম বাধা যা জেনারেটিভ এআই ব্যবহার করে অতিক্রম করা যায়।
প্রথমে, আসুন অন্তর্নিহিত স্থানীয় LLM প্রক্রিয়া এবং একটি AMD পরিবেশ বেছে নেওয়ার কারণগুলি সংক্ষিপ্ত করা যাক।
স্থানীয় এলএলএম-এর সাহায্যে ডেটা ইন-হাউস প্রক্রিয়া করা যেতে পারে।
এলএলএম (লার্জ-স্কেল ল্যাঙ্গুয়েজ মডেল) হল AI এর মূল যেটি মানুষের নির্দেশাবলী বোঝে এবং বাক্য, সারাংশ, অনুবাদ, প্রশ্নের উত্তর ইত্যাদি তৈরি করে।
ক্লাউড-ভিত্তিক পরিষেবা যেমন ChatGPT ইন্টারনেটের মাধ্যমে প্রদানকারীর সার্ভারে প্রবেশ করা পাঠ্য পাঠায় এবং প্রক্রিয়াকৃত ফলাফলগুলি গ্রহণ করে। অন্যদিকে, স্থানীয় এলএলএম তার নিজস্ব পিসি বা সার্ভারে মডেলটিকে পরিবর্তন করে এবং ইনপুট থেকে উত্তর প্রজন্ম পর্যন্ত সবকিছু সম্প্রচার করে।
দুটি প্রধান পার্থক্য আছে। প্রথমটি যেখানে ডেটা প্রক্রিয়া করা হয়। স্থানীয় LLM আপনাকে গোপনীয় সামগ্রী এবং গ্রাহকের তথ্য বাহ্যিক পরিষেবাগুলিতে পাঠানো ছাড়াই ব্যবহার করতে দেয়৷ ঐতিহ্যগতভাবে, অভ্যন্তরীণ নেটওয়ার্ক এবং ব্যবহারকারীর বিশেষাধিকারগুলির পরিচালনার জন্য আলাদাভাবে প্রয়োজন হয়, তবে এমন তথ্য পরিচালনা করতে সক্ষম হওয়ার একটি দুর্দান্ত সুবিধা রয়েছে যা জেনারেট করা AI-তে ইনপুট করা যায়নি কারণ এটি কোম্পানির বাইরে থেকে আসে।
ক্লাউড টাইপ এবং স্থানীয় এলএলএম এর তুলনা চিত্র
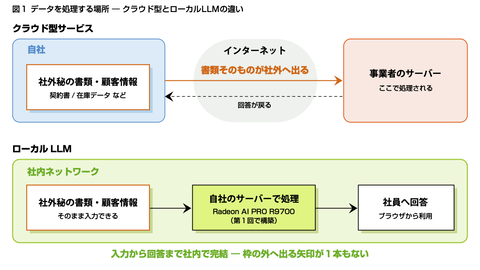
ক্লাউড টাইপ এবং স্থানীয় এলএলএম-এর মধ্যে পার্থক্য। ক্লাউড টাইপে, নথির বিষয়বস্তু একটি বাহ্যিক সার্ভারে পাঠানো হয়, কিন্তু স্থানীয় এলএলএম-এ প্রক্রিয়াকরণ অভ্যন্তরীণ নেটওয়ার্কে সম্প্রচার করা হয়।
দ্বিতীয়টি হল খরচ। ক্লাউড প্রকারের জন্য API ব্যবহারের পরিমাণের উপর নির্ভর করে একটি মাসিক লাইসেন্স এবং চলমান ফি প্রয়োজন। যদিও স্থানীয় LLM-এর জন্য একটি PC বা GPU-তে একটি প্রাথমিক বিনিয়োগের প্রয়োজন হয়, আপনি যতবার মডেলকে কল করুন না কেন কোনও ব্যবহার ফি নেই৷ যদিও বিদ্যুৎ এবং রক্ষণাবেক্ষণের খরচ আছে, মাসিক চার্জ কর্মচারীর সংখ্যা বা ব্যবহারের ফ্রিকোয়েন্সি অনুপাতে বাড়ে না, তাই আপনি যত বেশি পরিষেবা ব্যবহার করবেন খরচের পূর্বাভাস দেওয়া সহজ।
খরচের সাথে কীভাবে এগিয়ে যেতে হবে তার ধারণাগত চিত্র
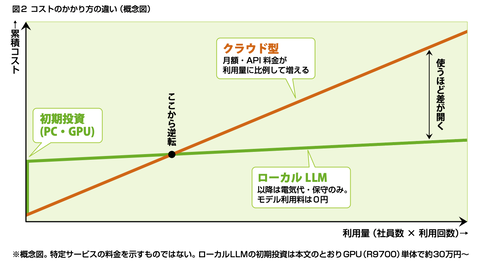
খরচের পার্থক্য। ক্লাউড-ভিত্তিক মডেলগুলির সাথে, খরচগুলি ব্যবহারের পরিমাণের অনুপাতে বাড়তে থাকে, যেখানে স্থানীয় LLMগুলির সাথে, প্রাথমিক বিনিয়োগের পরে বৃদ্ধি ধীরে ধীরে হয় এবং আপনি যত বেশি এটি ব্যবহার করেন পার্থক্যটি প্রসারিত হয়।
ক্লাউড-ভিত্তিক পরিষেবার বিকল্প যা ঘরে রাখা হয় তার পরিবর্তে আপনার কোম্পানির ডেটা এবং ক্রিয়াকলাপগুলির জন্য তৈরি করা যেতে পারে এমন একটি প্ল্যাটফর্ম হিসাবে স্থানীয় LLM ভাবা সহজ৷ মডেল নিজেই কোম্পানি-নির্দিষ্ট নিয়ম বা সর্বশেষ জায় সম্পর্কে জানেন না।
অতএব, এটি নথি অনুসন্ধান করার জন্য একটি ফাংশন এবং বহিরাগত প্রক্রিয়াকরণ কল করার একটি প্রক্রিয়া প্রদান করে এবং প্রতিটি কর্মচারীর প্রশ্নের জন্য প্রয়োজনীয় তথ্য নির্ধারণ করে।
স্থানীয় এলএলএম পরিবেশ স্তরে ছড়িয়ে রয়েছে যেমন:
- প্রশিক্ষিত বেস মডেল
- এক্সিকিউশন পরিবেশ যা মডেল চালায়
- RAG (অনুসন্ধান এক্সটেনশন জেনারেশন) যা অভ্যন্তরীণ নথি উল্লেখ করে
- UI যা কর্মীরা ব্রাউজার থেকে ব্যবহার করে
RAG একটি প্রশ্নের সাথে সম্পর্কিত নথি অনুসন্ধান করে এবং একটি উত্তরের জন্য বিষয়বস্তু LLM-এ পাস করে।
প্রক্রিয়া এবং নির্মাণ পদ্ধতির বিশদ বিবরণ অংশ 1 এ ব্যাখ্যা করা হয়েছে, তবে কীভাবে এগিয়ে যেতে হবে তার ব্যবহারিক উদাহরণগুলি এই বিন্দু পর্যন্ত শুধুমাত্র ভিত্তি দিয়ে পড়া যেতে পারে।
AMD পরিবেশ যা বাস্তবসম্মত বাজেটে 30B শ্রেণীর মডেল চালায়
স্থানীয় এলএলএম পিসিগুলির প্রথম বাধা হল GPU-তে ইনস্টল করা VRAM (ভিডিও মেমরি) এর ক্ষমতা। ছোট মডেল কম VRAM সঙ্গে চলতে পারে, কিন্তু আপনি যদি একটি 30B ক্লাস মডেল বেছে নেন, যার একটি প্রতিক্রিয়ার গুণমান রয়েছে যা ব্যবসায় ব্যবহার করা যেতে পারে বলে বলা হয়, একটি নির্দেশিকা 24GB বা তার বেশি এমনকি যখন পরিমাপ করা হয়। সাধারণ GPU-গুলির জন্য, বিকল্পগুলি এই বিন্দুর বাইরে হ্রাস পায় এবং মূল্য উল্লেখযোগ্যভাবে বৃদ্ধি পায়।
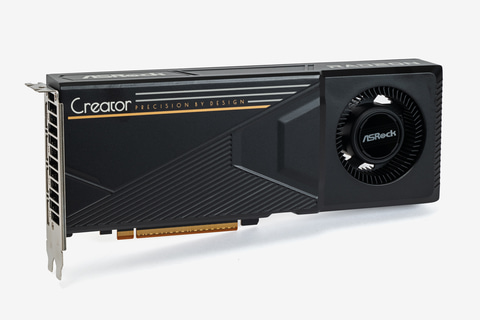
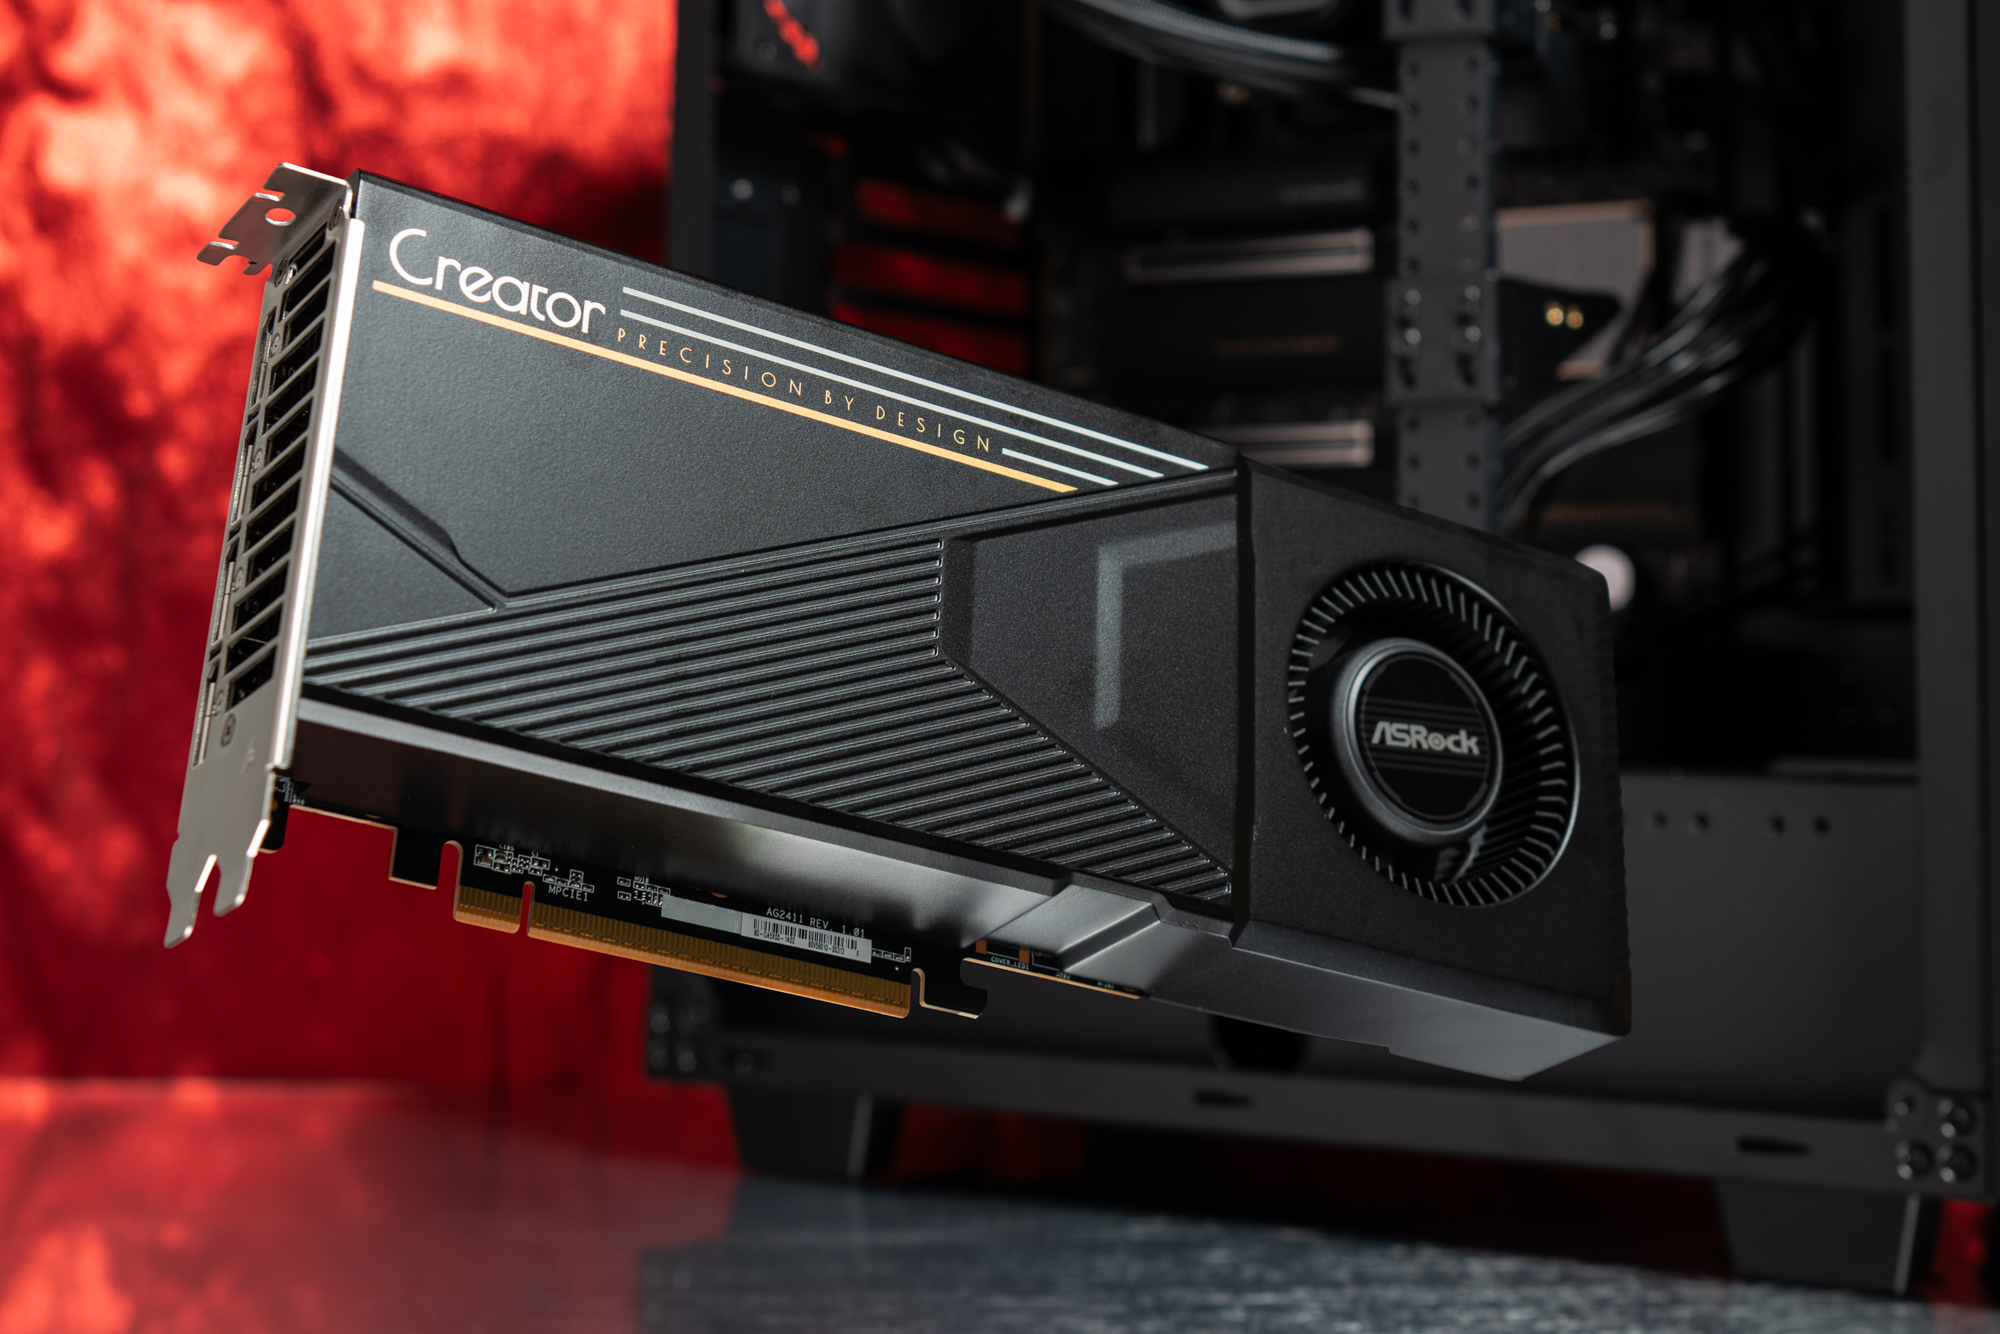
“AMD Radeon AI PRO R9700” 32GB বড় ক্ষমতার VRAM (GDDR6) দিয়ে সজ্জিত। RDNA 4 আর্কিটেকচার গ্রহণ করে, AI ইনফারেন্স পারফরম্যান্স INT8 এর সাথে 766TOPS এবং INT4 এর সাথে 1,531TOPS এ পৌঁছেছে (স্পর্সিটি ব্যবহার করার সময়)
সেখানেই “AMD Radeon AI PRO R9700” আসে৷ AMD এর Radeon AI PRO R9700 হল যদিও এটি 32GB VRAM-এর সাথে সজ্জিত, তবে 3 সেপ্টেম্বর, 2026 পর্যন্ত একটি পৃথক সমীক্ষা অনুসারে প্রকৃত বিক্রয় মূল্য ছিল প্রায় 300,000 ইয়েন। Radeon RX 9070 XT, যার দাম 16GB VRAM সহ প্রায় 130,000 ইয়েন, দাম কম রাখতে পারে, কিন্তু 30B ক্লাসে পর্যাপ্ত VRAM নেই৷ 32GB VRAM সহ একটি সাধারণ GPU-সজ্জিত ভিডিও কার্ডের দাম 800,000 ইয়েনের বেশি৷ 128GB VRAM ইউনিফাইড মেমরির সাথে বিক্রি হওয়া একটি মিনি পিসির দাম প্রায় 1 মিলিয়ন ইয়েন, এবং আমি এই সময় যে ভিএলএলএম ব্যবহার করছি তাও দেখব না।
ফলস্বরূপ, বৃহৎ ক্ষমতার VRAM এবং পরিচিতি মূল্যের মধ্যে ভারসাম্য বিবেচনা করে, Radeon AI PRO R9700 30B শ্রেণীর স্থানীয় LLM বাস্তবায়নের জন্য ছোট এবং মাঝারি আকারের উদ্যোগগুলির জন্য একটি বাস্তবসম্মত বিকল্প হয়ে উঠেছে।
VRAM ক্ষমতা x মূল্যের ডিস্ট্রিবিউশন ডায়াগ্রাম
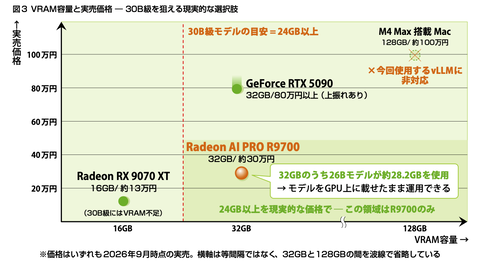
VRAM ক্ষমতা এবং প্রধান GPU এবং PC-এর প্রকৃত বিক্রয় মূল্য (3 সেপ্টেম্বর, 2026 অনুযায়ী)। Radeon AI PRO R9700 হল একমাত্র যেটি 24GB বা তার বেশি VRAM এর প্রয়োজনীয়তা পূরণ করতে পারে, যা 30B শ্রেণীর জন্য মানক, এবং দাম কম রাখে।
এই পিসির জন্য, আমরা 8টি কোর এবং 16টি থ্রেড Ryzen 7 9850X3D সহ Radeon AI PRO R9700 একত্রিত করেছি। এমন একটি পরিবেশে যেখানে LLM এবং RAG একসাথে ব্যবহার করা হয়, এটি শুধুমাত্র CPU কোরের সংখ্যা নয়, উচ্চ-গতির অনুসন্ধানের সময় র্যান্ডম অ্যাক্সেসের গতিও প্রভাবিত হয়। Ryzen 7 9850X3D 3D V-Cache ব্যবহার করে একটি বৃহৎ 96MB 3-টাইম ক্যাশে দিয়ে সজ্জিত, যা যেকোন সময় সার্চ থ্রুপুট উন্নত করবে বলে আশা করা যায়। এএমডি এনভায়রনমেন্টের শক্তি হল যে এটি শুধুমাত্র জিপিইউই নয় বরং সার্চ প্রসেসিংকে সমর্থন করে এমন সিপিইউকে একত্রিত করা সহজ।
এই মেশিনে একটি স্থানীয় LLM সার্ভার তৈরি করুন
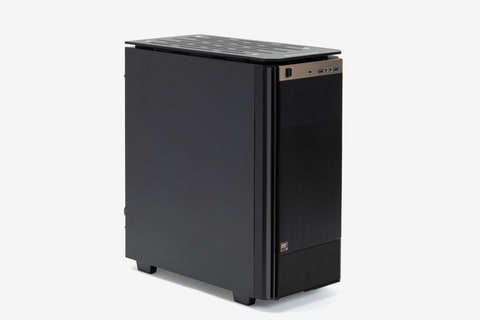
যাচাইকরণ মেশিনটি Radeon AI PRO R9700 (VRAM 32GB) + Ryzen 7 9850X3D, মেমরি 64GB এবং 1TB SSD সহ একটি কাস্টমাইজড TSUKUMO eX.computer ডেস্কটপ কম্পিউটার। Radeon AI PRO R9700 দিয়ে সজ্জিত “Radeon AI PRO মডেল” “QA9A-V255/XBH”, যার কাস্টমাইজড কনফিগারেশনের কারণে একটি ভিন্ন বিষয়বস্তু রয়েছে, 599,800 ইয়েনে বিক্রি হয়৷ আপনি এই মূল্যের জন্য কোনও মডেল ব্যবহার ফি ছাড়াই একটি স্থানীয় LLM সার্ভার তৈরি করতে পারেন।
একবার সার্ভার তৈরি হয়ে গেলে, মডেলটির জন্য মাসিক ব্যবহার ফি 0 ইয়েন। Gemma 4 26B-A4B-it-এর 4-বিট কোয়ান্টাইজেশন মডেল ব্যবহার করে প্রথমবার পরিমাপ করা হয়েছিল, এবং একটি শব্দের জন্য প্রজন্মের গতি ছিল 50.17tok/s, এবং 4টি শব্দের জন্য মোট 155.8tok/s (জনপ্রতি প্রায় 39tok/s)। স্থাপনার ইউনিটগুলিতে ব্যবহার করা হলে, একটি ব্যবহারিক প্রতিক্রিয়া গতি নিশ্চিত করা যেতে পারে এমনকি শুধুমাত্র একটি ইউনিটের সাথেও।
যেটি গুরুত্বপূর্ণ তা হল শুধুমাত্র ক্যাটালগে তালিকাভুক্ত কম্পিউটেশনাল পারফরম্যান্স নয়, আপনি VRAM-এ যে মডেলটি ব্যবহার করতে চান তা বরাদ্দ করার ক্ষমতা এবং একাধিক ব্যক্তির কাছ থেকে স্থিরভাবে অনুরোধগুলি প্রক্রিয়া করা। এই 26B মডেলটি আনুমানিক 28.2GB VRAM ব্যবহার করে, তাই Radeon AI PRO R9700, যা 32GB দিয়ে সজ্জিত, GPU-তে মাউন্ট করা মডেলের সাথে চালানো যেতে পারে। Radeon AI PRO R9700 বেছে নেওয়ার সবচেয়ে বড় কারণ হল আপনি অপেক্ষাকৃত কম প্রাথমিক খরচে প্রচুর পরিমাণ VRAM সুরক্ষিত করতে পারেন।
হার্ডওয়্যার কনফিগারেশন হল: GPU হল Radeon AI PRO R9700, CPU হল Ryzen 7 9850X3D, মেমরি হল 64GB, স্টোরেজ হল 1TB SSD, এবং OS হল Ubuntu 24.04.4 LTS৷ এখন থেকে, এই মেশিনটি কতদূর অনুশীলনে ব্যবহার করা যেতে পারে সেদিকে আলোকপাত করা যাক।
Radeon GPGPU গবেষণার অগ্রভাগে গৃহীত হয়
AMD Radeon এর AI প্ল্যাটফর্ম শুধুমাত্র দামের কারণে বেছে নেওয়া হয়নি। DEGIMA AI, যার CEO হলেন Tsuyoshi Hamada, যিনি GPGPU গবেষণায় অগ্রগামী হিসেবে পরিচিত, এছাড়াও AMD Radeon-কে তার AI প্ল্যাটফর্ম হিসেবে ব্যবহার করেন। এটা জেনে আশ্বস্ত হয় যে এমনকি ছোট এবং মাঝারি আকারের ব্যবসাগুলিও একই ধরনের GPU পরিবেশ ইনস্টল করতে পারে যা যুক্তিসঙ্গত মূল্যে বড় আকারের গণনার বিশেষজ্ঞরা বেছে নেন।
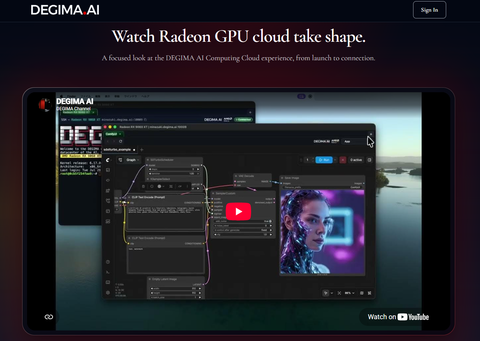
Tsuyoshi Hamada, GPGPU গবেষণায় অগ্রগামী হিসেবে পরিচিত, ডিজিআইএমএ এআই-এর সিইও হওয়ার সিদ্ধান্ত নিয়েছেন। আমরা AMD Radeon GPU-এর জন্য বিশেষায়িত একটি ক্লাউড প্ল্যাটফর্ম প্রদান করি এবং আপনি Radeon AI PRO R9700 নির্বাচন করতে পারেন।